En este artículo
Si usas Claude todos los días, ya sea en el chat, en Claude Code o desde la API, tarde o temprano te haces esta pregunta: ¿gasto menos tokens si le escribo en inglés?
La respuesta corta es sí, algo menos. La respuesta útil es otra: el idioma no es la palanca más grande. En este artículo te mostramos los datos, cuánto se traduce en dinero y qué conviene cambiar primero.
Qué es un token y por qué depende del idioma
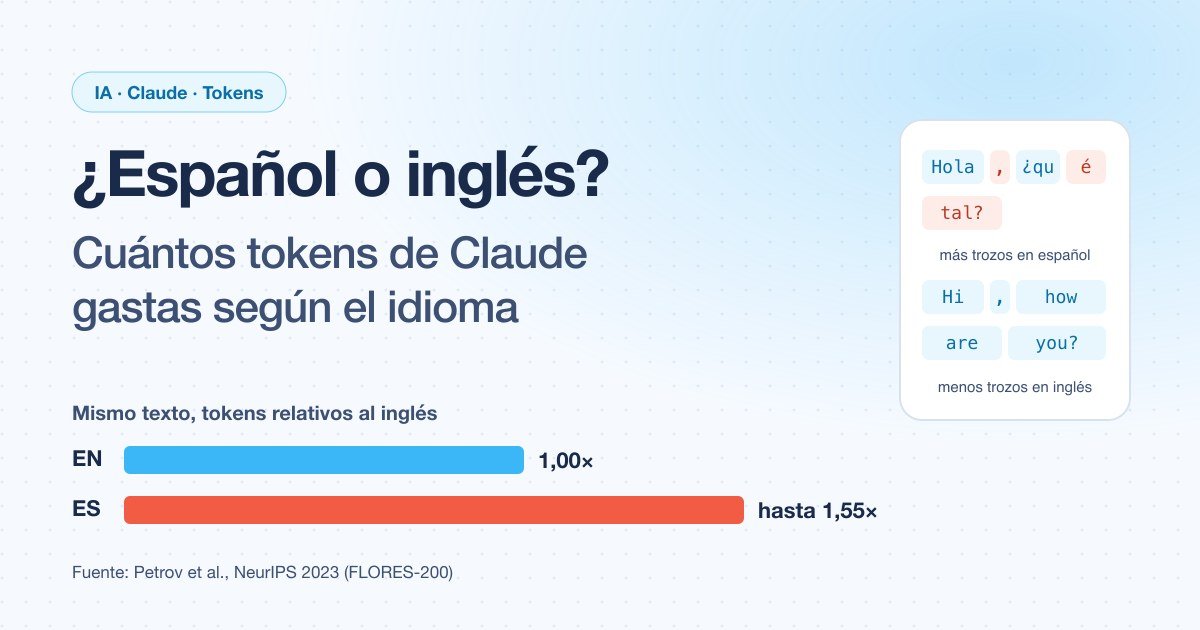
Claude no lee letras ni palabras. Lee tokens: trozos de texto que salen de un tokenizador. Una palabra común en inglés suele ser un solo token. Una palabra en español, sobre todo si lleva tilde, ñ o una conjugación larga, se parte a menudo en dos o tres trozos.
Esto pasa porque los tokenizadores aprenden su vocabulario de un corpus de entrenamiento, y en la mayoría de esos corpus el inglés domina. Las secuencias frecuentes en inglés quedan como una sola pieza. Las del español, no tanto.
El problema es que todo se cobra por token: lo que envías (entrada), lo que Claude responde (salida) y lo que cabe en la ventana de contexto. Más tokens implican más costo, más rapidez para llegar a los límites de uso y conversaciones que se llenan antes.
Lo que dicen los estudios
El trabajo de referencia es Language Model Tokenizers Introduce Unfairness Between Languages (Petrov, La Malfa, Torr y Bibi, NeurIPS 2023). Tomaron el mismo conjunto de frases traducidas a más de 200 idiomas (el corpus FLORES-200) y contaron cuántos tokens necesita cada tokenizador para cada idioma.
Con sus tablas públicas (repositorio en GitHub) calculamos cuántos tokens necesita el español en relación con el inglés (inglés = 1,00):
Tres lecturas rápidas:
- El español ya es más largo de base. Solo en caracteres, la misma frase ocupa un 19 % más que en inglés. Ningún tokenizador puede bajar de ahí sin un vocabulario pensado para el español.
- Los tokenizadores multilingües casi no penalizan. XLM-RoBERTa o BLOOM se quedan en 1,20×: prácticamente solo la diferencia de longitud del idioma.
- Los modelos con vocabulario centrado en el inglés penalizan bastante. GPT-4, LLaMA o Qwen piden entre 45 % y 55 % más tokens para decir lo mismo en español.
No estamos solos. Las demás lenguas romances y el alemán sufren algo parecido:
Otro estudio llega a una conclusión similar: Do All Languages Cost the Same? Tokenization in the Era of Commercial Language Models (Ahia et al., EMNLP 2023). Demuestra que, con APIs que cobran por token, los hablantes de idiomas distintos al inglés pagan más por el mismo servicio.
¿Y Claude?
Anthropic no publica su tokenizador, así que no hay una cifra oficial de español frente a inglés para Claude. Lo que sí sabemos:
- El tokenizador cambia entre generaciones. La propia Anthropic indica que el tokenizador que estrenó Claude Opus 4.7 usa entre 1× y 1,35× tokens respecto a los modelos anteriores para el mismo texto. Una cifra medida en un modelo no vale para otro.
- Lo razonable es esperar que Claude quede entre los dos extremos de la gráfica: por encima del 1,19× que impone la longitud del español y, probablemente, por debajo del 1,55× de los tokenizadores más sesgados.
- La única forma de saberlo con tu texto es medirlo. Al final del artículo tienes un script que lo hace gratis con la API de conteo de tokens.
En los cálculos que siguen usamos un supuesto de 1,30×. Es una estimación intermedia, no un dato oficial.
Cuánto dinero es en la práctica
Pongamos un caso típico: una app o un agente que hace 1000 consultas al mes con Claude Sonnet 5.5. Cada consulta envía 20 000 tokens de contexto (instrucciones, documentos, historial) y recibe una respuesta de 2000 tokens, medidos en inglés.
Precios de Claude Sonnet 5.5 en la API: 2 USD por millón de tokens de entrada, 10 USD por millón de salida y 0,10 USD por millón leídos desde la caché.
Las cuentas, consulta por consulta:
| Escenario | Entrada | Salida | Total por consulta | Al mes |
|---|---|---|---|---|
| Todo en inglés | 20 000 × $2/M = $0,040 | 2000 × $10/M = $0,020 | $0,060 | $60,00 |
| Prompt en inglés, respuesta en español | $0,040 | 2600 × $10/M = $0,026 | $0,066 | $66,00 |
| Todo en español | 26 000 × $2/M = $0,052 | $0,026 | $0,078 | $78,00 |
| Español + caché (80 % de la entrada) | 20 800 en caché ($0,002) + 5200 normales ($0,010) | $0,026 | $0,0385 | $38,50 |
| Inglés + caché (80 % de la entrada) | 16 000 en caché ($0,0016) + 4000 normales ($0,008) | $0,020 | $0,0296 | $29,60 |
La conclusión salta a la vista: pasar todo al inglés ahorra un 23 %, pero activar la caché en español ahorra un 51 %. Y una cosa no excluye la otra.
La salida pesa cinco veces más que la entrada
Hay un detalle que muchos pasan por alto: en Claude, un token de salida cuesta 5 veces lo que uno de entrada (10 USD frente a 2 USD en Sonnet 5.5; 20 USD frente a 4 USD en Opus 5.5).
Por eso, el truco de “escribo el prompt en inglés y le pido que responda en español” tiene un límite: solo recupera el extra de la entrada. El extra de la respuesta se queda, y ahí cada token cuesta 5 veces más. En el ejemplo baja de $78 a $66, pero no llega a los $60 de todo en inglés. Y si tu uso genera respuestas largas (redactar textos, generar código), casi todo el extra está en la salida y el truco apenas se nota.
Lo que sí mueve la aguja en la salida es pedir respuestas más cortas:
- “Responde en máximo 5 viñetas.”
- “Dame solo el código, sin explicación.”
- “Si la respuesta es sí o no, contesta solo eso.”
Una respuesta de 600 tokens en español es más barata que una de 2000 en inglés. La longitud importa más que el idioma.
Las palancas de ahorro, ordenadas
Si tu objetivo es ahorrar tokens (o dinero, o cupo de uso en tu plan), este es el orden en que conviene atacar:
1. Prompt caching
Si envías el mismo bloque grande una y otra vez (instrucciones de sistema, documentación, el código del proyecto), la caché hace que las relecturas cuesten un 10 % del precio normal. Es la palanca con mejor relación entre esfuerzo y ahorro. Claude Code ya la usa por ti; en la API la activas con cache_control.
La única regla: lo estable va primero y lo que cambia va al final. Una fecha o un ID distinto al inicio del prompt invalida toda la caché.
2. Elegir el modelo adecuado para cada tarea
Clasificar, extraer datos o resumir no necesita el modelo más grande. Claude Haiku 5.5 cuesta 0,10 USD por millón de tokens de entrada, frente a 4 USD de Opus 5.5. Reserva el modelo grande para lo que de verdad lo requiere.
3. Batch API para lo que no es urgente
Si puedes esperar la respuesta (procesar cientos de documentos, generar descripciones de productos), la Batch API cobra la mitad.
4. Contexto limpio
Cada mensaje vuelve a enviar todo el historial. Una conversación de 50 turnos sobre tres temas distintos paga, en cada turno, por los otros dos temas. En Claude Code:
- Usa
/clearcuando cambias de tarea. - Usa
/compactcuando la sesión es larga y quieres conservar solo lo importante. - Mantén tu
CLAUDE.mdcorto: se carga en cada sesión. UnCLAUDE.mdde 3000 tokens cuesta 3000 tokens antes de que escribas nada. - Señala archivos concretos (
src/lib/seo.js) en lugar de pedir “revisa todo el proyecto”.
5. Idioma
Ahora sí: si ya hiciste lo anterior y escribes prompts largos y repetitivos, escribirlos en inglés ahorra entre un 17 % y un 35 % de esos tokens. Para instrucciones de sistema fijas (que además van a caché) puede valer la pena. Para conversar día a día, escribe en el idioma en el que piensas con más claridad: un prompt ambiguo que obliga a repetir la pregunta cuesta más que cualquier diferencia de tokenización.
¿Conviene instalar memoria con grafo o base vectorial?
Una idea que circula mucho: instalar un servidor MCP de memoria con grafo de conocimiento o base de datos vectorial para que Claude “recuerde” y no haya que repetirle el contexto.
Antes de instalarlo, haz las cuentas:
- Cada herramienta MCP ocupa contexto. Las definiciones de herramientas se envían con las peticiones. Un servidor de memoria con 8 o 10 herramientas puede sumar miles de tokens por sesión, los uses o no.
- Recuperar recuerdos también son tokens. Lo que la memoria devuelve entra al contexto igual que si lo hubieras escrito tú.
- Claude Code ya trae memoria. El archivo
CLAUDE.mddel proyecto y la memoria automática guardan hechos en archivos pequeños que solo se cargan cuando son relevantes. Para un proyecto normal, eso cubre lo mismo sin servidores extra.
Una memoria vectorial empieza a compensar cuando tienes mucho conocimiento que no cabe en un CLAUDE.md (cientos de documentos, años de tickets) y solo necesitas recuperar fragmentos puntuales. Para un sitio web o una app mediana, suele gastar más tokens de los que ahorra.
Mídelo tú mismo con tu propio texto
La API de Anthropic tiene un endpoint para contar tokens sin generar respuesta y sin costo. Con este script comparas tu prompt real en español y en inglés usando el tokenizador real de Claude:
// contar-tokens.mjs — npm install @anthropic-ai/sdk
// Necesita ANTHROPIC_API_KEY en el entorno.
import Anthropic from "@anthropic-ai/sdk";

const client = new Anthropic();
const model = "claude-sonnet-5-5"; // prueba también con el modelo que uses

const textos = {
  es: "Revisa este componente de Vue y dime si hay fugas de memoria al desmontarlo. Responde en máximo cinco viñetas.",
  en: "Review this Vue component and tell me if there are memory leaks when it unmounts. Answer in at most five bullet points.",
};

const conteo = {};
for (const [idioma, texto] of Object.entries(textos)) {
  const { input_tokens } = await client.messages.countTokens({
    model,
    messages: [{ role: "user", content: texto }],
  });
  conteo[idioma] = input_tokens;
}

console.log(conteo);
console.log(`Español / inglés: ${(conteo.es / conteo.en).toFixed(2)}×`);
Prueba con textos largos y representativos de tu uso real (un prompt de sistema completo, un documento, una conversación). Con frases cortas el resultado varía mucho, porque cada mensaje lleva unos tokens fijos de formato.
Resumen
- El mismo texto en español usa entre 1,2× y 1,55× los tokens del inglés, según el tokenizador (Petrov et al., NeurIPS 2023).
- Para Claude no hay cifra oficial. Mídelo con
count_tokens: es gratis. - La salida cuesta 5 veces la entrada. Pedir respuestas cortas ahorra más que cambiar de idioma.
- Caché, modelo adecuado, Batch API y contexto limpio ahorran mucho más que escribir en inglés.
- Antes de instalar memorias con grafo o vectores, cuenta los tokens que agregan. En proyectos medianos,
CLAUDE.mdy la memoria integrada suelen bastar.
Si estás integrando Claude en tu negocio y quieres que salga barato desde el primer día, cuéntanos tu proyecto.
Temas de este artículo