En este artículo
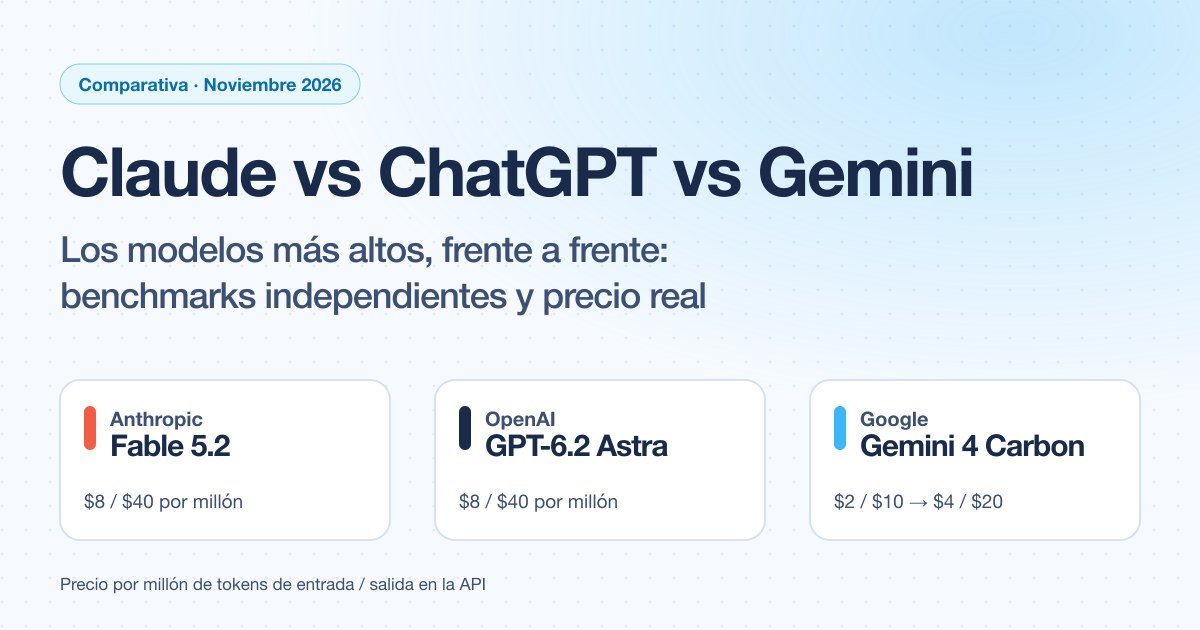
Cada pocas semanas sale un modelo que “supera a todos”. En noviembre de 2026, las tres grandes empresas de IA tienen modelo nuevo en la cima: Anthropic con Claude Fable 5.2, OpenAI con GPT-6.2 Astra y Google con Gemini 4 Carbon.
En este artículo los comparamos con datos que se pueden verificar: benchmarks medidos por evaluadores independientes, precios oficiales de cada API y costo real por tarea. Al final te decimos cuál conviene según lo que vas a construir.
Nota importante: los benchmarks cambian casi cada semana. Todos los datos de este artículo son del 19 de noviembre de 2026. Si lo lees meses después, revisa las fuentes enlazadas al final.
Los contendientes
| Claude Fable 5.2 | GPT-6.2 Astra | Gemini 4 Carbon | |
|---|---|---|---|
| Empresa | Anthropic | OpenAI | |
| Producto de consumo | Claude | ChatGPT | Gemini |
| Ventana de contexto | 1 M de tokens | 1,05 M de tokens | 1 M de tokens |
| Salida máxima | 128 K tokens | 128 K tokens | 64 K (hasta 1 M en modo largo) |
| Entrada (por millón) | $8 | $8 | $2 hasta el 30/11 · $4 desde el 1/12 |
| Salida (por millón) | $40 | $40 | $10 hasta el 30/11 · $20 desde el 1/12 |
| Lectura desde caché (por millón) | $0,20 | $0,40 | $0,10 · $0,20 desde el 1/12 |
| Niveles de razonamiento | low → max | low → max | low, medium, high |
Precios estándar de cada API. GPT-6.2 Astra duplica el precio de entrada cuando el prompt pasa de 272 K tokens.
Dos aclaraciones:
- ChatGPT, Claude y Gemini son las apps; los modelos que comparamos son los más potentes que cada empresa ofrece en su API. Qué modelo ves en la app depende del plan que pagues.
- Cada empresa tiene además un modelo “un escalón abajo”, mucho más barato: Claude Opus 5.5 ($4 / $20), GPT-6.2 Sol ($2 / $10) y Gemini 4 Argon / Neon. Los mencionamos donde aportan.
Inteligencia frente a costo
El mejor punto de partida independiente es el Intelligence Index de Artificial Analysis: una batería de pruebas de razonamiento, conocimiento, código y agentes que corren ellos mismos con cada modelo, con su configuración más alta. También miden cuánto cuesta en dólares completar una tarea, que es más justo que comparar el precio por token, porque cada modelo “piensa” una cantidad distinta de tokens.
Qué nos dice la gráfica:
- Claude Fable 5.2 en modo
maxes el más inteligente (65 puntos), pero también el más caro por tarea: $26,54, más de 6 veces lo que cuesta GPT-6.2 Astra. - Fable 5.2 en
highempata con GPT-6.2 Astra (62 puntos), pero cuesta más del doble por tarea ($9,08 frente a $4,00). - GPT-6.2 Astra tiene la mejor relación inteligencia/precio de los tres modelos de cima.
- Gemini 4 Carbon queda a 2 puntos de Astra, con un costo intermedio. Ojo: ese costo se midió con el precio de lanzamiento, que se duplica el 1 de diciembre.
Benchmarks independientes, prueba por prueba
Las empresas publican sus propios resultados, pero suelen elegir las pruebas y configuraciones que más las favorecen. Aquí solo usamos mediciones de terceros: Vals AI y ARC Prize.
Programación y agentes en terminal
En Terminal-Bench 4.0 (tareas reales en una terminal: compilar, depurar, configurar servidores), Claude Fable 5.2 es primero de 63 modelos con 65,2 %. Gemini 4 Carbon queda muy cerca (63,1 %) y GPT-6 Astra algo más atrás (59,6 %).
En pruebas más específicas de Vals, Fable 5.2 también lidera Vibe Code Bench (crear apps completas desde cero: 93,8 %) y Code Migration (migrar código entre versiones: 83,3 %).
Razonamiento abstracto
ARC-AGI-3 mide si el modelo resuelve juegos y acertijos que nunca vio. Con el arnés estándar, Fable 5.2 saca 81,2 %, muy por encima de Gemini 4 Carbon (65,1 %) y GPT-6 Astra (62,7 %). Un matiz: cuando cada empresa usa su propio adaptador, los tres pasan del 97 %, y GPT-6 Astra llega a 99,9 %.
Trabajo de oficina especializado
Aquí Gemini 4 Carbon sorprende. En Tax Agent Bench (declaraciones de impuestos con agentes) es primero con 51,8 %, frente a 32,1 % de Fable 5.2. También queda arriba de Claude en el Legal Index de Vals (75,9 % frente a 69,2 %).
Ciencia
GPT-6 Astra gana en Terminal-Bench-Science de Vals (62,9 % frente a 55,7 % de Fable 5.2): tareas científicas que se resuelven con código en terminal.
El promedio general
En el Vals Index, que combina todas sus pruebas, Fable 5.2 es primero (71,3 %) y Gemini 4 Carbon tercero (70,5 %), con márgenes de error que se superponen. Es decir: en promedio, están prácticamente empatados.
Cuánto cuesta un trabajo real
El precio por token no lo es todo, pero es lo que vas a ver en tu factura. Supongamos 1000 tareas, cada una con 20 000 tokens de entrada y 2000 de salida, a precio de lista y sin caché:
Tres cosas que esta cuenta simple no muestra:
- Los tokens de razonamiento. Los tres modelos “piensan” antes de responder y ese pensamiento se cobra como salida. Por eso el costo por tarea de Artificial Analysis (primera gráfica) es más realista: ahí GPT-6.2 Astra sale bastante más barato que Fable 5.2, aunque el precio por token sea el mismo.
- El tokenizador. El mismo texto no ocupa los mismos tokens en cada modelo, y en español la diferencia crece. Lo explicamos en ¿Español o inglés? Cuántos tokens de Claude ahorras según el idioma.
- La caché. Si repites contexto (instrucciones, documentos, código), los tres cobran entre $0,10 y $0,40 por millón en relecturas. En aplicaciones reales, esto puede bajar la factura a la mitad o más.
¿Cuál elegir?
No hay un ganador absoluto. Depende de lo que vayas a construir:
| Si necesitas… | Te conviene | Por qué |
|---|---|---|
| Agentes de programación, terminal y tareas largas | Claude Fable 5.2 | 1.º en Terminal-Bench 4.0, Vibe Code Bench y Code Migration |
| La máxima inteligencia sin importar el costo | Claude Fable 5.2 (max) | Mejor puntaje en el Intelligence Index y en ARC-AGI-3 |
| Mucha inteligencia por cada dólar | GPT-6.2 Astra | 62 puntos a $4 por tarea, el mejor equilibrio de los tres |
| Tareas científicas con código | GPT-6 Astra | 1.º en Terminal-Bench-Science |
| Legal, impuestos, finanzas | Gemini 4 Carbon | 1.º en Tax Agent Bench, 3.º en Legal Index |
| Analizar video y audio | Gemini 4 Carbon | Acepta texto, imagen, video, audio y PDF como entrada |
| Buena calidad gastando la mitad | Claude Opus 5.5 o GPT-6.2 Sol | El escalón de abajo cuesta la mitad o menos |
En nuestro trabajo diario en Tinguar, la regla que mejor nos funciona es esta: usa el modelo más alto solo donde la diferencia se nota. Para clasificar, resumir o extraer datos, un modelo intermedio o pequeño da el mismo resultado por una fracción del precio. Para un agente que escribe y prueba código durante horas, el modelo de cima se paga solo.
Y el consejo más importante: prueba con tus propios datos. Un benchmark mide un promedio. Tu caso de uso es uno solo. Toma 20 o 30 ejemplos reales de tu trabajo, pásalos por los tres modelos y compara.
Fuentes
- Precios y especificaciones oficiales: Anthropic (Claude), OpenAI (modelos) y precios, Google (Gemini 4 Carbon) y precios.
- Benchmarks independientes: Artificial Analysis, Vals AI y ARC Prize.
- Recopilaciones consultadas: Techarion (11/11/2026) y Widelai (10/11/2026).
Si quieres integrar alguno de estos modelos en tu negocio y no sabes cuál te conviene, cuéntanos tu proyecto y lo evaluamos con tus datos.